Czy jeśli zablokujesz trenowanie modeli AI na tekstach ze swojej strony, Twoja firma zniknie z Google? Słyszę to pytanie coraz częściej, a od 30 października 2026 roku będę je słyszał jeszcze częściej. Tego dnia Google ogłosił, że będzie respektował wspólny sygnał w pliku robots.txt, którym jednym wpisem powiesz „nie” trenowaniu modeli u wielu firm naraz. Według Search Engine Land podobne deklaracje złożyły tego samego dnia Microsoft Bing, OpenAI i Anthropic.
Krótka odpowiedź brzmi: nie, z wyników wyszukiwania przez to nie wypadniesz. Dłuższa jest ciekawsza, bo Google ma dziś trzy różne przełączniki, które z daleka wyglądają podobnie, a robią zupełnie co innego. Pomylenie ich potrafi kosztować więcej niż sama decyzja o trenowaniu.
Co Google ogłosił 30 października
Wpis na blogu Google Search Central podpisał John Mueller. Google zapowiada obsługę wspólnego „policy token”, czyli specjalnej nazwy w pliku robots.txt, opracowanej w grupie roboczej AIPREF przy IETF (organizacji, która tworzy standardy internetu). Zamiast pisać osobne reguły dla każdej firmy rozwijającej modele językowe, właściciel strony ustawi jedną.
Najważniejsze zdanie z ogłoszenia: jeśli strona użyje tego tokenu, żeby nie zgodzić się na trenowanie, a nie ma osobnej reguły dla Google-Extended, Google potraktuje to tak, jakby Google-Extended był zablokowany. Dotychczasowe reguły dla konkretnych firm dalej działają. Możesz więc ustawić ogólne „nie” dla wszystkich, a dla Google zrobić wyjątek albo odwrotnie.
Termin? Na blogu Google pisze o 2027 roku, a w dokumentacji robotów Google doprecyzowano, że chodzi o początek 2027 roku. Dziś to zapowiedź, a nie działająca funkcja.
Jak ma wyglądać wpis w robots.txt
Szczegóły opisuje szkic dokumentu IETF z 30 października 2026 roku. Nie ma tam nowych poleceń. Token wpisujesz w linii User-Agent, a dalej działają zwykłe Allow i Disallow:
User-Agent: __usage_ai-training
Disallow: /
Disallow oznacza sprzeciw wobec trenowania na danych ścieżkach, Allow oznacza zgodę. W szkicu jest przykład, w którym cała strona jest zablokowana, a katalog z materiałami prasowymi pozostaje otwarty. Takie wyjątki będą więc możliwe.
Dla mnie najważniejszy jest jeden zapis ze szkicu: grupa User-Agent: * nie może być traktowana jako pasująca do tego tokenu. Jeśli w Twoim robots.txt nie ma osobnej grupy z __usage_ai-training, to w sprawie trenowania nie wyraziłeś żadnej preferencji, nawet jeśli w gwiazdce blokujesz pół strony. Pamiętaj też, że to wersja 00 szkicu. Do 2027 roku zapis może się jeszcze zmienić.
Trzy przełączniki, które łatwo pomylić
Tu zaczyna się praktyka. Kiedy ktoś mówi mi „wyłączyłem AI na stronie”, zawsze dopytuję, który z trzech przełączników ma na myśli.
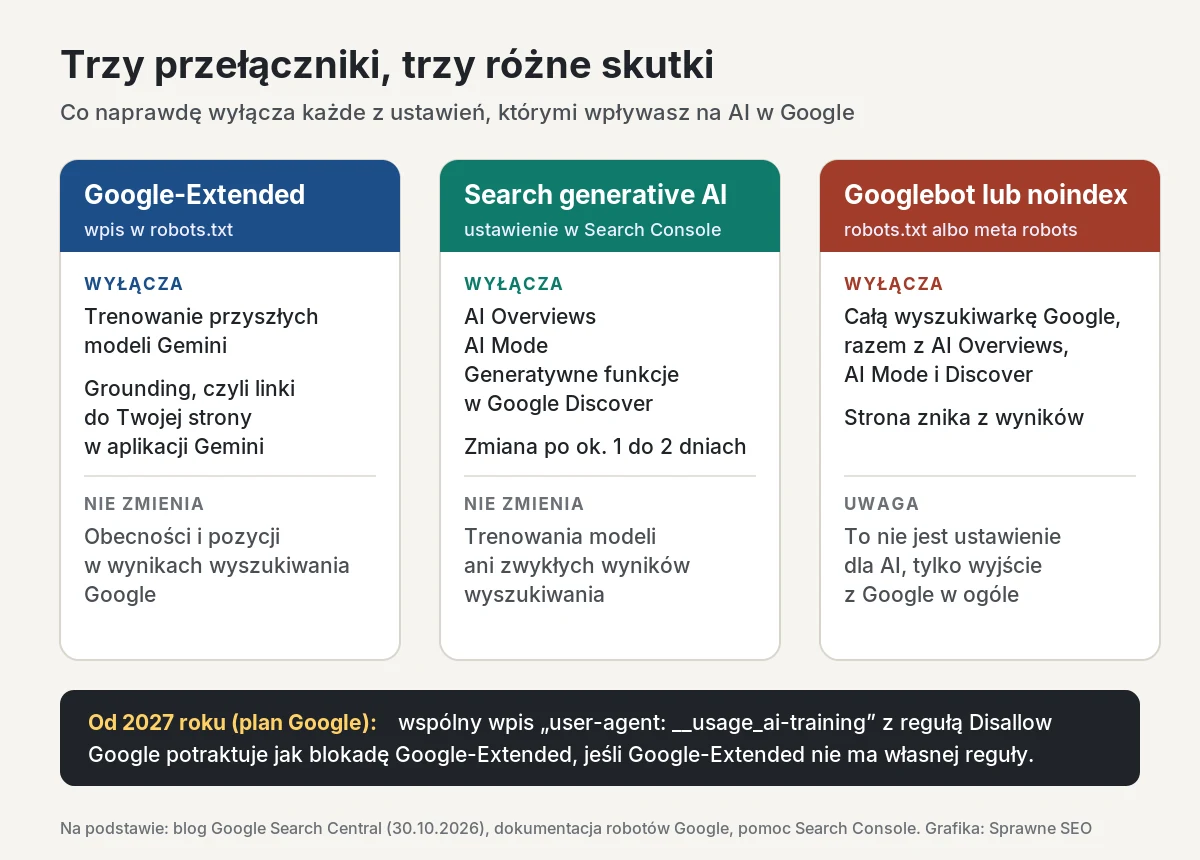
Google-Extended to reguła w robots.txt. Według dokumentacji decyduje, czy treści z Twojej strony mogą służyć do trenowania przyszłych modeli Gemini oraz do groundingu, czyli podpierania odpowiedzi w aplikacji Gemini treściami z indeksu wyszukiwarki. Google pisze wprost, że nie wpływa na obecność strony w wyszukiwarce i nie jest sygnałem rankingowym. Jest jedno ale: strony, które na Google-Extended pozwalają, mogą pojawiać się w odpowiedziach Gemini i dostawać z nich kliknięcia. Po zablokowaniu tę szansę tracisz.
Search generative AI to ustawienie w Search Console (Ustawienia, potem Search generative AI), dostępne dla wszystkich stron od 31 sierpnia 2026 roku. Decyduje, czy Twoja strona pojawia się w AI Overviews, AI Mode i funkcjach generatywnych w Discover. Według pomocy Google nie dotyczy trenowania modeli i nie jest sygnałem rankingowym dla reszty wyników. Działa na całą usługę w Search Console, a zmiana wchodzi zwykle po jednym lub dwóch dniach.
Googlebot i noindex to w ogóle nie są ustawienia „dla AI”. Blokada Googlebota albo noindex wyrzuca stronę z wyszukiwarki razem ze wszystkimi funkcjami, także tymi generatywnymi.
Nowy wspólny token, z punktu widzenia Google, zastąpi tylko pierwszy z tych przełączników. Na AI Overviews i zwykłe wyniki nie wpłynie.
Trenowanie to decyzja biznesowa, nie techniczna
Wyobraź sobie swoją stronę jako półkę w ogromnej czytelni. Pytanie nie brzmi „czy ktoś może przeczytać moje książki”, bo wyszukiwarka i tak je czyta. Pytanie brzmi, czy pozwalasz na nich uczyć kolejne modele.
Wydawca, który żyje z unikalnych artykułów, autor płatnych kursów czy serwis z własnymi danymi branżowymi mają mocne powody, żeby powiedzieć „nie”. Ich treść jest produktem. U małej firmy usługowej sprawa wygląda inaczej: strona to opis oferty, cennik, obszar działania i odpowiedzi na pytania klientów. Gdy pomagam w takiej decyzji, pytam przede wszystkim, czy firmie zależy na tym, żeby aplikacje takie jak Gemini znały ją i linkowały do niej. Jeśli tak, blokada trenowania i groundingu raczej jej nie pomoże. To jednak moja ocena, a nie reguła Google. Decyzję podejmujesz Ty.
Wyjście z AI Overviews ma swoją cenę
Drugi przełącznik kusi najbardziej, bo AI Overviews kojarzą się z odbieraniem kliknięć. 30 października Search Engine Roundtable opisał mały eksperyment Cyrusa Sheparda. Wykluczył on jedną stronę z funkcji generatywnych w Search Console, a potem przywrócił ustawienie.
Wyświetlenia w funkcjach AI spadły od razu do zera. Stanowiły około 8% wszystkich wyświetleń strony. Szacowany CTR tych wyświetleń wyniósł około 0,9%. Najbardziej zaskoczyło go to, że w czasie wykluczenia spadły też kliknięcia ze zwykłych wyników. Na adresach najczęściej widocznych w AI pozycja spadła, a po ponownym włączeniu wzrosła.
Zanim przyjmiesz te liczby za pewnik: to jedna strona, mała próba i wynik wyliczony pośrednio. Search Engine Land zwraca uwagę, że nie podano ruchu, dat ani skali spadku. Traktuję to jako sygnał, nie dowód. Na pewno wystarczy, żeby nie wyłączać AI Overviews „na wszelki wypadek”. Przed jakąkolwiek zmianą sprawdź w Search Console, ile wyświetleń faktycznie masz w tych funkcjach. Jak to zrobić, opisałem we wpisie o tym, jak sprawdzić widoczność strony w AI Overviews i AI Mode.
Czego bym nie robił przed 2027 rokiem
- Nie blokowałbym Googlebota, „żeby AI nie czytało strony”. Efekt będzie taki, że strona zniknie z Google, a nie tylko z funkcji AI.
- Nie dodawałbym nosnippet na całą witrynę. Ta reguła ukrywa opis także w zwykłych wynikach, więc płacisz za nią klikalnością.
- Nie liczyłbym na to, że wpis z
__usage_ai-trainingjuż dziś działa w Google. Możesz go dodać, ale jeśli chcesz teraz wyłączyć trenowanie w Gemini, nadal potrzebujesz reguły dla Google-Extended. - Nie zakładałbym, że reguły w grupie z gwiazdką coś mówią o trenowaniu. Według szkicu nie mówią nic.
- Nie kopiowałbym z internetu gotowych plików robots.txt z listą kilkudziesięciu robotów. Jeden źle przypisany Disallow potrafi zablokować więcej, niż chciałeś. Po każdej zmianie zajrzyj do raportu robots.txt w Search Console.
Moje domyślne ustawienie dla małej firmy
Jeśli prowadzisz firmę usługową albo sklep i nie sprzedajesz samych treści, zostawiam zwykle Search generative AI na „uwzględniaj”, robots.txt bez blokady Googlebota i podejmuję świadomą decyzję o Google-Extended razem z właścicielem. Wspólny token wrócę sprawdzić, kiedy Google ogłosi, że faktycznie go obsługuje. Wtedy sprawdzę też, czy zapis ze szkicu się nie zmienił.
Plik robots.txt to jeden z pierwszych plików, które otwieram, kiedy zaczynam pozycjonowanie strony firmowej w Google, bo często pamięta jeszcze poprzedniego wykonawcę. Jeśli nie wiesz, co jest w Twoim, napisz do mnie, a sprawdzę, które z tych trzech przełączników masz dziś ustawione i czy zgadza się to z tym, czego chcesz.
Źródła: Google Search Central Blog, „Supporting a shared AI training control for websites”, 30.10.2026; dokumentacja Google, lista robotów i opis Google-Extended; pomoc Search Console, ustawienie Search generative AI; Google Search Central, „Control what you share with Google Search”; IETF, szkic „Machine-Readable Training Preference Signal”; Search Engine Land, 30.10.2026; Search Engine Roundtable, badanie CTR w AI Overviews i AI Mode, 30.10.2026; Search Engine Land, test wykluczenia z funkcji AI.